SQLite im Bot-Betrieb: Zugriffe, Sicherungen und Grenzen
Eine gemeinsame SQLite-Datei kann mehrere Yurna-Anwendungen verbinden, verlangt aber klare Betriebsregeln. Dieser Artikel erklärt kurze Schreibvorgänge, WAL, konsistente Sicherungen und Wiederherstellung anhand eines Ticketablaufs und trennt Quellcodeabsichten von tatsächlich geprüften Einstellungen.
 BlackZack
1569 Wörter · 8 Min. Lesezeit
- yurna
- sqlite
- backups
- betrieb
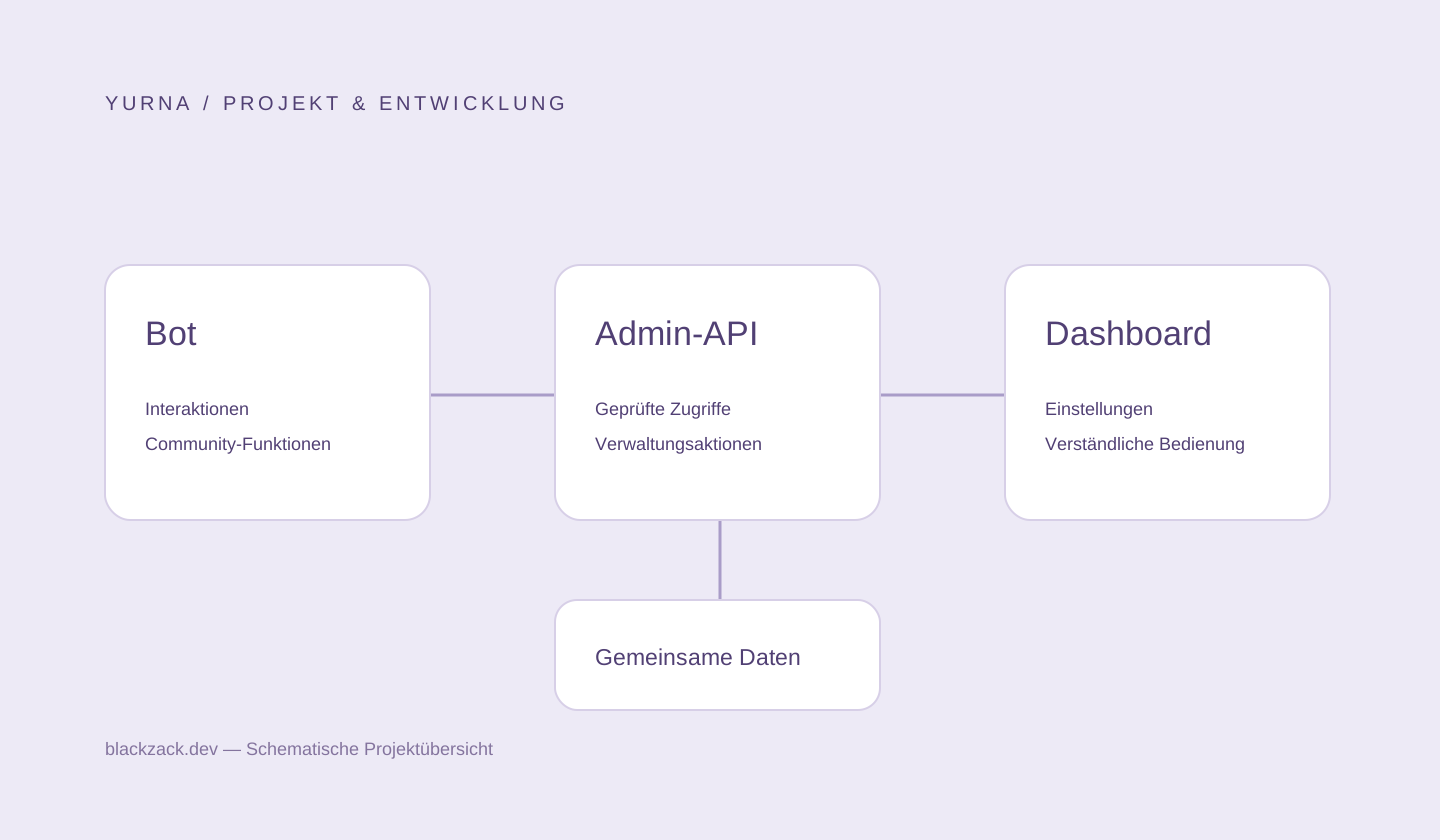
Schematische Illustration zur Artikelserie; keine privaten Betriebsdaten.
Eine Datenbankdatei ist angenehm überschaubar. Sie lässt sich benennen, sichern und in einer Testumgebung öffnen. Gerade diese Einfachheit kann jedoch zu falschen Annahmen führen: Ein gewöhnlicher Dateikopiervorgang sei immer eine vollständige Sicherung, drei Anwendungen könnten unbegrenzt gleichzeitig schreiben oder eine erfolgreich gesetzte Konfiguration gelte automatisch für jede Verbindung. SQLite nimmt viele Aufgaben ab, aber die Anwendung muss ihre Zugriffe und ihren Betrieb passend organisieren. Für Yurna betrifft das Bot, Dashboard und Admin-API gleichermaßen.
Im untersuchten Prisma-Schema ist SQLite als Anbieter eingetragen. Der gemeinsame Client versucht nach dem Verbindungsaufbau unter anderem WAL, eine Wartefrist bei Sperren und Fremdschlüsselprüfungen zu konfigurieren. Diese Beobachtung beschreibt den vorhandenen Initialisierungscode. Ob die Einstellungen in einer konkreten laufenden Verbindung wirksam sind, muss separat überprüft werden. Besonders Kommentare über erwartete Vorteile ersetzen keine Messung und keine Prüfung der tatsächlichen Datenquelle. Der Artikel entwickelt deshalb einen Betriebsentwurf mit klaren Nachweisen.
Die gemeinsame Datei eindeutig identifizieren
Der erste Betriebsfehler kann auftreten, bevor eine einzige schwierige Abfrage ausgeführt wird. Bot und Dashboard verwenden denselben relativen Dateinamen, lösen ihn aber von verschiedenen Arbeitsverzeichnissen aus auf. Beide starten erfolgreich und zeigen unterschiedliche Daten. Im Yurna-Schema wird der Datenbankpfad aus der Umgebung bezogen; ein Kommentar weist auf die Bedeutung einer gemeinsamen Datei hin. Diese Entscheidung ist nur dann wirksam, wenn alle beteiligten Anwendungen tatsächlich dieselbe gewünschte Datenquelle erreichen.
Für eine Bereitstellung wird deshalb ein eindeutiger interner Datenbankbezug dokumentiert. Die Dokumentation muss keine geheimen Zugangsdaten enthalten. Sie soll klären, welches Volume oder welcher Speicherort von welchen Prozessen verwendet wird und wie eine Testinstanz davon getrennt bleibt. Besonders ein Wiederherstellungstest darf nicht versehentlich die produktive Datei öffnen. Eine erfolgreiche Verbindung ist kein Beweis für den richtigen Zielbestand. Eine harmlose bekannte Testmarkierung in einer isolierten Umgebung kann die Zuordnung überprüfbar machen.
Dateirechte gehören ebenfalls zum gemeinsamen Betrieb. Eine Anwendung, die lesen kann, aber keine notwendigen Begleitdateien anlegen darf, kann in bestimmten Situationen unerwartet scheitern. Umgekehrt sollte nicht jeder Prozess auf dem Host die Datenbank verändern können. Der Entwurf hält die beteiligten Benutzer und Speicherzugriffe überschaubar. Solche Grundlagen sind oft wichtiger als frühe Feinabstimmung einzelner SQL-Abfragen, weil sie sämtliche Funktionen betreffen und Fehler sonst sehr unterschiedlich sichtbar werden.
Schreibarbeit kurz und fachlich geschlossen halten
Ein Ticketabschluss kann mehrere lokale Änderungen benötigen: Status ändern, Abschlusszeit setzen und eine Aktion protokollieren. Diese Änderungen gehören zusammen. Ein externer Discord-Aufruf zur Anpassung des Kanals gehört dagegen nicht in eine lange gehaltene Datenbanktransaktion. Während auf das Netzwerk gewartet wird, sollte kein unnötiger Schreibanspruch bestehen bleiben. Der Ablauf speichert eine klare lokale Entscheidung und bearbeitet die externe Wirkung anschließend als eigenen Schritt.
Das ist keine Aufforderung, zusammengehörige Daten beliebig aufzuteilen. Die fachliche Einheit muss gerade präzise bestimmt werden. Status und zugehöriger Abschlussgrund sollten nicht unabhängig voneinander in widersprüchlichen Kombinationen sichtbar werden. Ein späterer Transkriptdownload kann dagegen als Nachbereitung geführt werden. Wer diese Grenzen sorgfältig zieht, erreicht sowohl verständliche Zustände als auch kurze Datenbankarbeit. Leistung und Nachvollziehbarkeit unterstützen sich hier gegenseitig, statt gegensätzliche Ziele zu sein.
Ein häufiger Gegenentwurf lädt zunächst viele Daten, wartet auf mehrere externe Antworten und schreibt am Ende eine große Menge zurück. Das verlängert nicht nur die Bearbeitung, sondern erhöht auch die Wahrscheinlichkeit, auf veralteten Informationen aufzubauen. Für Yurna ist es sinnvoller, Eingaben und externe Voraussetzungen möglichst vor der kurzen verbindlichen Änderung zu prüfen. Der abschließende Schreibzugriff bestätigt dann noch einmal die relevanten aktuellen Bedingungen, beispielsweise die erwartete Ticketversion.
Was WAL verbessert und was nicht
Die SQLite-Dokumentation zu WAL beschreibt ein Verfahren, bei dem Änderungen zunächst in eine zusätzliche Protokolldatei gelangen. Es kann das Zusammenspiel von Lesern und Schreiber verbessern, macht SQLite aber nicht zu einer Datenbank mit beliebig vielen gleichzeitigen Schreibern. Für die Betriebsplanung bleibt deshalb wichtig, wie oft und wie lange geschrieben wird. Ein aktiviertes WAL ersetzt keine kurzen Transaktionen und keine Begrenzung großer Hintergrundarbeiten.
Im Yurna-Client wird die Aktivierung versucht und ein Fehler protokolliert. Für eine Betriebsprüfung wird der tatsächliche Modus über dieselbe Art von Verbindung abgefragt, die später verwendet wird. Auch Einstellungen mit Verbindungsbezug müssen passend betrachtet werden. Ein einmaliger manueller Test in einer separaten Konsole belegt nicht automatisch jede spätere Anwendungssitzung. Die Prüfroutine sollte deshalb Teil eines nachvollziehbaren Start- oder Diagnoseschritts sein und nur die benötigten nicht sensiblen Ergebnisse melden.
-- Lesende Diagnosebeispiele für eine bewusst ausgewählte Testdatenbank.
PRAGMA journal_mode;
PRAGMA synchronous;
PRAGMA busy_timeout;
PRAGMA foreign_keys;
Die Ausgaben werden im Zusammenhang interpretiert. Eine gesetzte Wartefrist bedeutet beispielsweise nicht, dass nie ein Sperrfehler auftritt. Sie begrenzt nur ein bestimmtes Warteverhalten. Eine lange Frist kann zudem eine Benutzeraktion spürbar verzögern. Der Bot braucht weiterhin eine rechtzeitige Interaktionsbestätigung und eine verständliche spätere Antwort. Datenbankeinstellungen und Bedienverhalten müssen zusammenpassen; keine der beiden Ebenen kann die andere vollständig ersetzen.
Sperrkonflikte nicht blind wiederholen
Ein vorübergehend blockierter Schreibzugriff kann nach kurzer Zeit erfolgreich sein. Trotzdem sollte ein Wiederholungsmechanismus wissen, ob der fachliche Vorgang bereits teilweise ausgeführt wurde. Bei einer klar abgeschlossenen lokalen Transaktion ist diese Frage anders zu behandeln als bei einem Ablauf mit externer Nachricht. Eine pauschale Wiederholung der gesamten Funktion könnte eine Nachricht doppelt senden, obwohl nur der letzte Datenbankschritt erneut erforderlich wäre. Wiederholbarkeit muss am Vorgang entworfen werden.
Für den Ticketentwurf wird eine eindeutige Abschlussaktion verwendet. Ist sie bereits gespeichert, liefert ein weiterer Aufruf diesen Stand zurück. Ist sie noch nicht gespeichert, kann die kurze lokale Änderung erneut versucht werden. Dabei gelten begrenzte Versuche und eine insgesamt vertretbare Wartezeit. Nach deren Ablauf erhält die Oberfläche einen nachvollziehbaren Fehler. Ein unendlicher Hintergrundloop würde die Störung lediglich verbergen und zugleich weitere Arbeit aufstauen.
Häufige Sperrkonflikte sind außerdem ein Signal für Untersuchung. Vielleicht schreibt ein Statistikjob zu große Blöcke, eine Abfrage hält eine Verbindung unnötig lange offen oder mehrere Prozesse aktualisieren dieselbe Zeile sehr häufig. Die richtige Reaktion ist nicht automatisch eine längere Wartefrist. Zunächst werden Dauer, Häufigkeit und betroffene Vorgänge erfasst. Danach kann die Arbeit verkleinert, zusammengefasst oder anders terminiert werden. Die Ursache bestimmt die Verbesserung.
Eine Sicherung braucht einen konsistenten Stand
Bei einer laufenden Datenbank sollte nicht unbesehen nur die sichtbare Hauptdatei kopiert werden. Die SQLite-Dokumentation zur Online Backup API beschreibt einen dafür vorgesehenen Sicherungsweg. Für einen konkreten Betrieb wird ein unterstütztes Werkzeug oder eine passende Bibliotheksfunktion gewählt, die diesen Zweck erfüllt. Der Artikel gibt bewusst keinen kopierfertigen Befehl für eine unbekannte produktive Installation vor. Zuerst müssen Zielpfad, Speicherplatz, Zugriffsrechte und Rückmeldung feststehen.
Eine Sicherung erhält einen eindeutigen Zeitpunkt und einen Bezug zur Anwendungsversion beziehungsweise zum Schemazustand. Sonst liegt später zwar eine Datei vor, aber niemand weiß, welche Version sie lesen kann. Zusätzlich wird festgehalten, ob zugehörige Dateianhänge im selben Sicherungskonzept enthalten sind. Yurnas Tickets können lokale Transkript- und Anhangsdateien verwenden. Eine reine Datenbanksicherung kann dann Einträge wiederherstellen, deren Dateien fehlen. Vollständigkeit wird deshalb aus Sicht der Funktionen geprüft, nicht allein anhand einer Dateigröße.
Der Sicherungsjob meldet seinen tatsächlichen Abschluss. Eine gestartete Aufgabe ist noch keine verwendbare Sicherung. Auch ein vorhandener Dateiname reicht als Nachweis nicht aus, wenn der Vorgang während des Schreibens abgebrochen ist. Der Entwurf kann eine fertige Sicherung erst nach erfolgreicher Prüfung als verfügbar markieren. Aufbewahrungsregeln sollten ältere brauchbare Stände nicht entfernen, bevor ein neuer Stand erfolgreich vorliegt. So wird ein vorübergehender Fehler nicht zur stillen Lücke in der gesamten Sicherungskette.
Wiederherstellen in einer getrennten Umgebung
Eine Sicherung wird wertvoll, wenn sich daraus die benötigten Funktionen wiederherstellen lassen. Dafür wird ein Exemplar in eine isolierte Testumgebung eingespielt. Die Testanwendungen erhalten ausschließlich den Testpfad und keine Möglichkeit, echte Discord-Aktionen auszulösen. Anschließend werden ausgewählte Datenbeziehungen geprüft: ein Mitglied mit Fortschritt, ein Ticket mit Nachrichten und ein Verweis auf ein Transkript. Diese Stichproben ersetzen keine vollständige Integritätsprüfung, ergänzen sie aber um fachliche Bedeutung.
Für das Ticketbeispiel muss der Abschlussstatus zur Aktionsgeschichte passen. Das zugehörige Transkript muss geöffnet werden können, und fehlende Anhänge müssen als solche erkennbar bleiben. Ein bloßer erfolgreicher Start des Dashboards wäre ein zu schwacher Test. Viele Fehler zeigen sich erst in einer bestimmten Detailansicht. Die Wiederherstellungsprobe verwendet daher eine kleine feste Sammlung repräsentativer Fälle, deren erwartetes Verhalten vorab beschrieben ist.
Auch die Zeit bis zur nutzbaren Wiederherstellung wird beobachtet, ohne daraus erfundene Leistungsversprechen abzuleiten. Welche Schritte benötigen manuelle Entscheidungen? Welche Dateien müssen zusätzlich bereitliegen? Welche Anwendungsversion wird gebraucht? Diese Erkenntnisse fließen in eine kurze Anleitung. Im Ernstfall sollte niemand erst aus alten Protokollen rekonstruieren müssen, wie Datenbank, Dateispeicher und Anwendungen zusammengehören. Eine geübte Abfolge ist hilfreicher als eine große Sammlung ungetesteter Sicherungsdateien.
Grenzen anhand der Arbeit erkennen
SQLite wird nicht allein deshalb ungeeignet, weil mehrere Anwendungen existieren. Umgekehrt ist eine kleine Datei kein Beweis, dass jede Last problemlos bleibt. Relevanter sind die Anzahl konkurrierender Schreibvorgänge, ihre Dauer und die Verteilung der Zugriffe. Ein Bot mit seltenen Einstellungen kann andere Anforderungen haben als ein System mit häufigen Ereignisprotokollen und umfangreichen Hintergrundauswertungen. Die Entscheidung für eine andere Datenbank sollte auf beobachteten Engpässen und zukünftigen Anforderungen beruhen.
Vor einer Migration lohnt sich die Prüfung einfacher Ursachen. Werden unnötig vollständige Datensätze geladen? Werden Statistikwerte für jedes einzelne Ereignis separat geschrieben, obwohl eine begrenzte Zusammenfassung fachlich ausreichen würde? Fehlen passende Indizes für häufige Übersichten? Solche Verbesserungen können unabhängig vom Datenbankprodukt sinnvoll sein. Ein Wechsel des Systems beseitigt kein unklar entworfenes Datenmodell und keine unnötig langen Transaktionen. Er verändert lediglich die verfügbaren Betriebs- und Skalierungsmöglichkeiten.
Für Yurna ergibt sich daraus eine nüchterne Betriebsregel: gemeinsame Datenquelle nachweisen, kurze lokale Änderungen entwerfen, Einstellungen überprüfen und Wiederherstellung üben. WAL und eine passende Wartefrist können dabei helfen, sind aber keine Ersatzgarantie. Die Datenbank bleibt dann ein überschaubarer verlässlicher Baustein. Ihre Einfachheit wird genutzt, ohne die notwendigen Grenzen zwischen laufenden Zugriffen, Sicherungen und externen Discord-Wirkungen zu übersehen.
Ein zusätzlicher Prüfpunkt betrifft freien Speicherplatz. Datenbank, Protokolldateien, Sicherungen und Ticketanhänge teilen möglicherweise denselben begrenzten Datenträger. Eine erfolgreiche Sicherung von gestern verhindert keinen Schreibfehler von heute. Deshalb sollte die Betriebsbeobachtung den tatsächlich verwendeten Speicherbereich berücksichtigen und bei absehbarer Knappheit eine konkrete Handlung auslösen. Alte Sicherungen werden dabei nach einer festgelegten Regel entfernt, nicht spontan als erste Reaktion auf jeden Fehler. So bleibt die Entlastung planbar, ohne gerade den benötigten Wiederherstellungsstand zu verlieren.